Google DeepMind发布多语言手语转文本模型,率先接入Pixel 11
Google DeepMind于2026年8月12日发布手语转文本模型SL2T,并将其用于Pixel 11上的Gboard和Live Transcribe。首批功能仅支持美国手语转英文,更多设备和语言仍处于后续计划阶段。
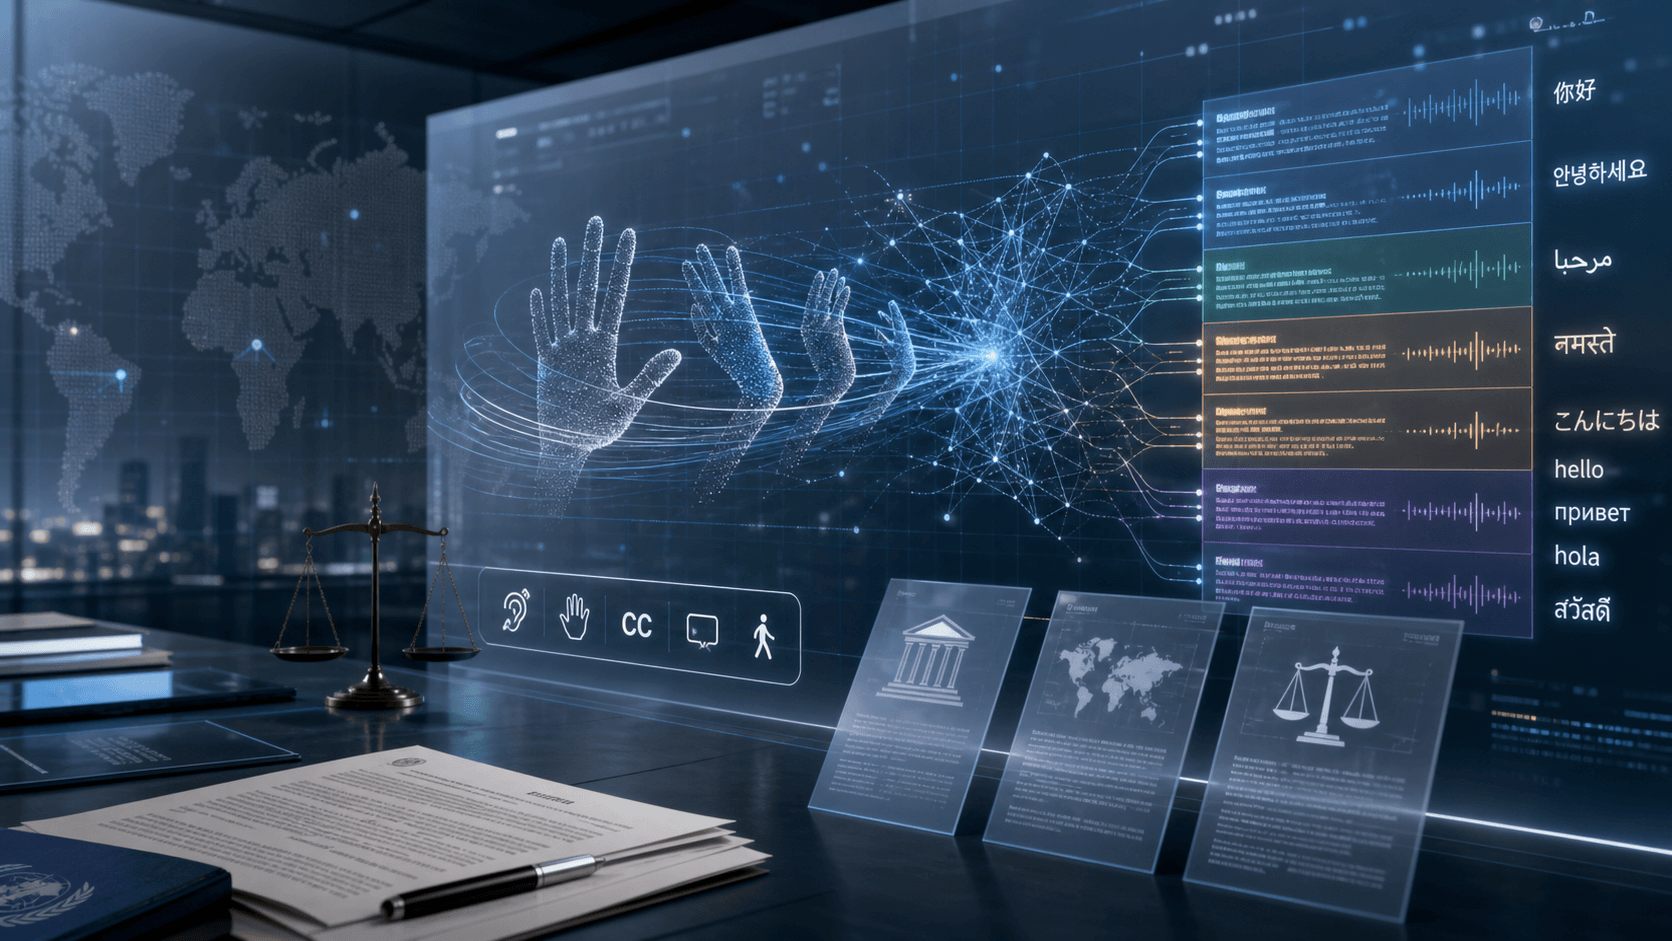
Google DeepMind在2026年8月12日发布手语转文本模型SL2T,并宣布将其用于面向聋人及听障用户的新功能。根据该公司当天发布的官方介绍,SL2T已为Pixel 11上的Gboard和Live Transcribe提供手语转文字能力,初始支持范围为美国手语(ASL)到英文。
在Gboard中,用户可以通过手机摄像头打手语,由模型生成流式文本,用于网页搜索、撰写消息或文档,以及向Gemini提交问题或任务。在Live Transcribe中,用户可以用手语生成文字回复,减少交谈过程中反复键入文字的需要。Google称,参与测试的用户认为,以美国手语表达比输入英文更快、更自然;这一说法来自公司测试反馈,官方页面没有提供独立研究结果或量化对照数据。
Google表示,全球有超过200种手语,约7000万聋人和听障人士使用这些语言。手语并不是口语或书面语的逐词替换系统,而是具有独立语法和词汇的自然语言。因此,相关模型需要完成语言翻译,而非把单个手势依次对应为英文单词。
技术上的另一项难点来自视觉处理。手语意义由手、手臂、躯干、头部和面部的同步动作共同传递,模型需要以较高帧率识别细微的全身运动。官方展示显示,SL2T会把签名者的身体动作转换为关键点表示,再输出连续文本。Google据此指出,只感知手部动作的手语手套等早期方案无法覆盖完整的语言信息。
据Google披露,SL2T使用超过10万小时、覆盖50多种手语的数据训练。公司将其描述为大规模多语言模型,但首批消费者功能并未同时开放全部训练语言:目前官方明确确认的产品能力仍是Pixel 11上的美国手语转英文。Google表示,更多设备将很快加入,其他语言也会随后推出,但没有在该页面给出具体设备名单、语言清单或上线时间表。
此次发布的直接意义在于,Google把手语识别从研究展示接入了Gboard和Live Transcribe两个消费者功能,并允许生成的文字继续用于Gemini交互。不过,官方材料没有证明这些功能已在Pixel 11用户中形成广泛采用,也没有披露识别准确率、不同场景表现、商业结果或长期无障碍影响。现阶段可以确认的是产品范围和技术路线,实际覆盖程度仍需等待后续设备、语言支持及公开评估。