AI 上线之后,谁负责持续监测?
一个部署在东南亚市场的中文客服机器人,被用户几轮追问后做出了一笔企业从未授权的退款承诺;一个金融场景的定价助手,在数据分布悄然漂移后,连续数周给出偏离风控区间的报价。这两类问题有一个共同点:它们都落在上线测试的覆盖范围之外,往往在系统运营数周甚至数月后才显形。 美国框架:监测被写进闭环
上线之后才暴露的那类事故
一个部署在东南亚市场的中文客服机器人,被用户几轮追问后做出了一笔企业从未授权的退款承诺;一个金融场景的定价助手,在数据分布悄然漂移后,连续数周给出偏离风控区间的报价。这两类问题有一个共同点:它们都落在上线测试的覆盖范围之外,往往在系统运营数周甚至数月后才显形。(以航空公司客服机器人错误承诺退款、最终被裁定需为该承诺担责为代表的一类事故,属公开报道形态;该具体案例未经核实,标注为 unverified。)
对把 AI 系统推向新加坡与东南亚市场的中国企业而言,运行期出了事谁负责,已经从一个运维细节上升为模型选择的前置变量。在新加坡以问责(accountability)为核心的监管取向下,一个模型能否被采用,越来越取决于它在运行期能否持续产出可出示的监测与事故证据。这一要求对美系模型供应商和中国出海供应商一视同仁,它重新定义了「模型够不够好」这个问题的答案。
美国框架:监测被写进闭环
NIST 于 2023 年 1 月发布的《AI 风险管理框架》(AI 100-1) 把风险管理定义为贯穿治理(Govern)、映射(Map)、测量(Measure)、管理(Manage)四个职能的持续过程。其中 Manage 直接对应部署之后:模型漂移、滥用、边界外行为与事故响应,都被放在上线之后的持续动作里。2024 年 7 月发布的《生成式 AI 应用指引》(AI 600-1) 进一步把生成式系统的滥用、内容风险、上线后监测与退役/再训练边界纳入治理建议。
这套框架是一个闭环,而闭环有一个具体的断裂点:Measure 阶段选定的指标在上线那一刻被冻结,系统面对的数据分布、用户行为和攻击手法却持续变化。没有 Manage 阶段的监测把漂移信号送回 Measure 与 Govern,指标就会逐渐失真——企业以为系统仍在合规区间,实际可能早已越界。对管理层的含义很直接:追责时的第一个问题不是「上线前测过没有」,而是「运营期间谁在看、看到后谁处置」。
新加坡框架:问责是一种持续状态
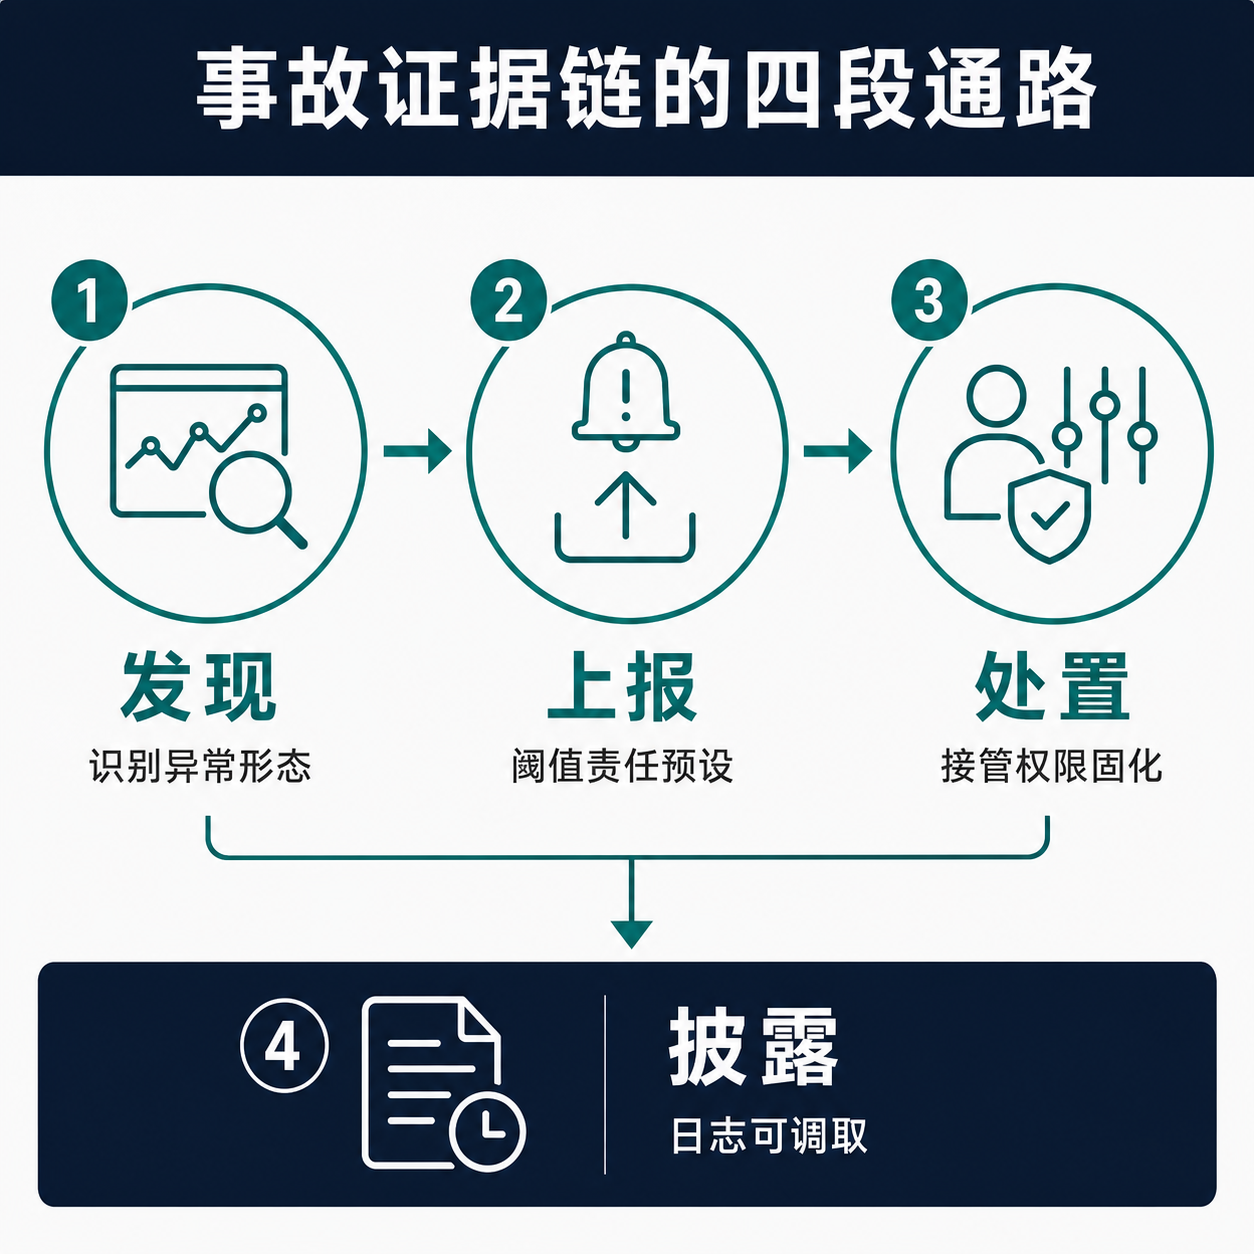
新加坡 AI Verify Foundation 与 IMDA 于 2024 年 5 月联合发布《生成式 AI 模型治理框架》,把问责、事故报告、测试与保证等九个维度并列为落地要件。「事故报告」维度尤其关键:它预设事故会发生,要求企业预先建立发现、上报、处置与披露的通路。
把这条通路拆开看,每一段都对应一个可以失效的机制。发现,取决于监测指标是否覆盖了这次异常的形态——一个只监测服务可用性的看板,抓不到定价助手的语义漂移。上报,取决于阈值和责任人是否事先约定——没有触发线,异常会被当成噪声消化掉。处置,取决于人工接管的条件是否写死——「谁有权把系统降级或下线」如果悬空,第一反应往往是等待授权。披露,取决于证据是否完整且可调取——若关键日志缺失或存在不可出示的法域,企业面对监管者时只能陈述而无法举证。(框架列明事故报告为治理维度属已给来源;上述四段通路的机制拆解为分析推演。)IMDA 配套的 AI Verify 测试框架,则把这种保证要求落到可执行的测试与文档上;PDPC 关于「新加坡 AI 治理路径」的资料同样强调,每一个投入运营的 AI 系统都应能指向明确的责任主体和一套可出示的证据。
承载这些动作的管理体系标准是 ISO/IEC 42001,它于 2023 年 12 月发布,被广泛称为首个面向 AI 管理体系的国际标准(「首个」为公开通行说法)。其核心要求是建立、维护并持续改进一套可审计的制度化机制。三层叠加,新加坡对企业的要求是一种被持续维持的状态:合规证据需要通过监测、测试和文档不断刷新,一次性认证替代不了运行期的可信度。
三角结构:谁为运行期证据负责
美国框架提供风险管理的方法,新加坡监管提出问责的硬要求,中国出海的模型供应商与企业客户正好夹在两者中间。当一家中国企业在东南亚部署生成式应用,它通常要在两类模型之间做区域选择:一类是经由云服务落地的美系模型(如通过 Azure、AWS 提供的 OpenAI、Anthropic 系列),另一类是中国出海的大模型与 API(如阿里云通义千问在新加坡区域的部署、深度求索 DeepSeek 的 API、商汤等厂商的东南亚业务)。上述中国供应商在新加坡的具体合规部署与数据驻留安排未经核实,标注为 unverified。
真正的区域选择点落在运行期证据的归属上:事故发生时,监测数据由谁持有、事故通路由谁触发、责任主体能否向 IMDA 和企业大客户出示证据。基准分和调用价格在这一层几乎不构成区分度。在新加坡的问责逻辑下,模型供应商与企业客户之间的责任必须显式切分:哪些漂移与滥用信号由供应商侧监测、哪些由部署方自行盯防、事故发生时谁先响应、日志与证据存放在哪个法域。采购合同若只覆盖模型可用性(SLA),而把漂移、滥用与事故证据的产出留白,企业客户就会在监管问责面前独自承担运行期风险。对中国供应商而言,能否为出海客户提供这套运行期证据能力,正在成为其进入 ASEAN 市场的门槛之一。
这一判断成立的触发条件是:新加坡监管者或东南亚大额采购方开始在合同与审计中要求运行期证据,而不只是上线前的评估报告。可观察的反证是:若该市场的大额 AI 采购仍主要以基准分和价格排序、合同仍只写可用性,那么问责证据尚未成为选择变量,前述结论需相应下修。
一个跨境场景:证据法域如何决定问责落点
把切分抽象说清楚不够,落到一个可名状的部署上更能看见风险的形状。设想一家中国金融科技公司在新加坡上线跨境定价与客服助手,核心模型来自一家外部供应商,通过云区域调用。系统运营到第七周,数据分布漂移,助手对一批小微客户连续给出偏离风控区间的报价,直到一名客户投诉才被人工发现。
按新加坡的问责逻辑,IMDA 追问的不是模型跑分,而是这条证据链能不能被完整出示:漂移从哪一天开始、监测指标为何没有更早触发、谁在什么时间做了降级处置、相关输入输出日志是否留存。问题的关键在于这些日志物理存放在哪个法域。如果监测数据与调用日志驻留在供应商的境外基础设施,且合同没有约定企业客户对原始日志的调取权,那么在新加坡受问责的是持牌运营的这家企业,而能出示证据的却是不在此监管管辖内的供应商——问责主体与举证能力发生分离。这道裂缝不是模型能力问题,采购时把日志驻留法域和调取权写进合同,才是把它补上的动作。(该部署场景为说明性分析,非特定已发生事故;IMDA 以问责与事故报告为治理维度、企业须能指向责任主体并出示证据,属已给来源。具体供应商的数据驻留安排仍标注为 unverified。)
监测责任最终落在法域错位上
要在这样的环境里长期运营,企业需要一份运行责任台账,把每个生产环境中的 AI 系统的责任显式记录下来。它至少覆盖五个维度:监测指标、日志、升级路径、人工接管,以及供应商边界。但台账真正要解决的,不是“有没有记录”,而是出事时谁能举证。上线后的 AI 系统往往跨越模型供应商、云平台、企业业务部门和本地监管辖区;责任主体分散,证据却必须在一个调查窗口里被调出来。
这就是本文与其他治理文章的区别:持续监测的核心不是泛化的运行期证据,而是问责主体与举证能力的法域分离。模型可能由美国公司提供,应用由中国企业集成,数据落在新加坡或东盟某个市场,事故却由本地监管部门追问。若日志驻留在境外、供应商合同没有调取时限、企业内部没有异常升级负责人,即使监测面板显示“有记录”,也未必能在监管需要时形成证据。
可操作的起点,是为每个对外 AI 系统建立一张“举证地图”:哪类异常由谁判断,原始日志存在哪里,哪些证据可在本地调取,哪些需要供应商协助,合同承诺的响应时间是多少,何种情形触发暂停或下线。每月复盘不应只问本月指标是否正常,而要抽查一次模拟事故:能否在规定时间内还原输入、输出、模型版本、人工接管与处置动作。持续监测的最后价值,是把本地问责主体和境外证据控制权之间的错位提前暴露出来:监管追问的是本地企业,能不能举证却取决于它是否事先拿到了跨境供应商的证据调取权。
| 责任维度 | 典型失效场景 | 问责/举证落点 | 上线前应写进合同或台账的控制动作 |
|---|---|---|---|
| 监测指标 | 看板只监测服务可用性,抓不到定价助手的语义漂移 | 异常数周后经客户投诉才显形,问责时无早期信号可出示 | 约定覆盖漂移与滥用形态的指标由供应商侧或部署方哪一侧监测,并留存触发记录 |
| 上报阈值 | 无事先约定的触发线,异常被当作噪声消化 | 无法证明「何时应知、何时实知」,追责时时间线断裂 | 预设阈值与责任人,异常越线即生成可调取的上报记录 |
| 人工接管与处置 | 「谁有权降级或下线」悬空,第一反应是等待授权 | 处置延迟本身成为问责点,且无处置动作证据 | 把接管条件、授权人与下线触发情形写死并留痕 |
| 日志与证据法域 | 监测与调用日志驻留供应商境外基础设施 | 受问责主体(本地持牌企业)与举证能力(境外供应商)分离 | 合同写入本地企业对原始日志的调取权、调取时限与驻留法域 |
| 供应商边界 | SLA 只覆盖模型可用性,漂移/滥用/事故证据产出留白 | 企业客户在监管问责前独自承担运行期风险 | 显式切分供应商侧与部署方的监测责任及事故首响主体 |
采购谈判前就把这五行的「谁监测、证据存哪个法域、多久能调取」写进合同,否则受问责的本地企业会在出事时拿不出证据。
资料来源
6 个公开来源,按文章核验用途列出。