从模型到 Agent,美国平台开始内置执行环境
过去两年,衡量大模型的标准是基准分数:谁在推理、编码、多语言测试上领先。这条线索正在失效。 OpenAI 把工具与 Responses API 平台化
Agent 竞争进入执行责任层
过去两年,衡量大模型的标准是基准分数:谁在推理、编码、多语言测试上领先。这条线索正在失效。真正拉开差距的地方,从“模型能答对什么”移到了“模型能在你的系统里动手做什么”——工具调用、代码执行、浏览器与计算机操作、跨小时的长任务,以及可供审计的治理日志。这些能力过去只是开发者文档里的样例代码,如今被几家美国平台公司整体产品化,成为云平台的一层基础设施。
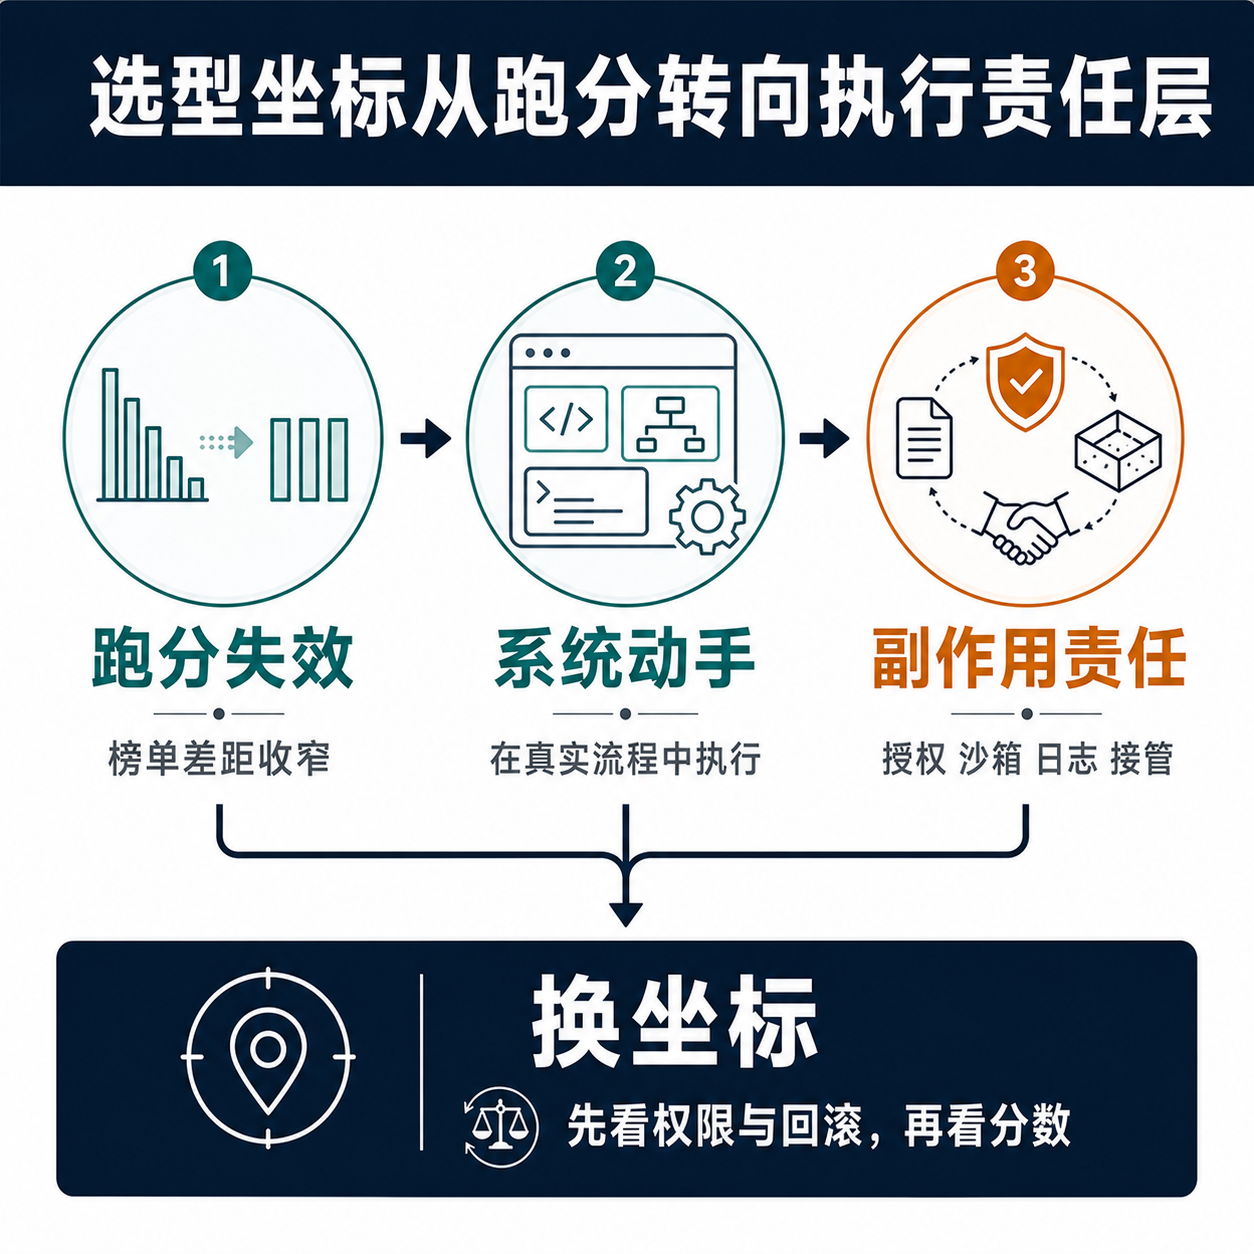
本文的独立落点不是开放协议与专有接口的路线选择,而是执行环境带来的责任转移。只要 agent 能下单、改数据库、发邮件、调用代码或浏览器,平台就不再只是回答问题的模型供应商,而是在客户系统里创造副作用的执行层。副作用一旦发生,企业不能再把风险归到“模型输出不准”;它必须说明谁授权、在哪个沙箱运行、哪条日志记录了动作、何时由人接管。
对创始人和 CTO,选型坐标要换一套。模型榜单只回答“够不够聪明”,执行责任层回答“能不能在你的系统里安全地干活”。评估一个平台,先看它的权限、沙箱、日志、人工接管和事故回滚,再看模型分数。对东盟决策者还多一层:当中美平台都把 agent 执行能力做进云产品,采购风险不只来自模型来源,还来自执行日志、数据驻留和事故责任能否在本地监管下被调取。
OpenAI 把工具与 Responses API 平台化
OpenAI 的策略是把 agent 的运行循环压缩成一个平台原语。据其开发者文档与产品页,Responses API 把"发出模型请求、触发工具、回填结果、继续下一步"这条链路合进单一接口;Agents SDK 在其上提供编排、状态与工具接入的骨架。开发者原本要手写的那段控制流——判断模型何时该调工具、如何把工具输出喂回上下文、循环何时终止——现在由平台托管。直接后果是集成成本大幅下降:一个团队不必自建 agent 运行时,就能让模型稳定地多轮调用工具、处理长任务。
代价在依赖结构里。Responses API 是 OpenAI 的专有接口,把执行循环交给它,等于把 agent 最核心的运行逻辑绑在一家美国供应商的平台上。要迁移到别的模型或自建栈,重写的不是几句 prompt,而是整套编排与工具接入。对东盟买家,这层绑定还叠加一个中美变量:一旦供应商侧的出口管制、账号或价格政策收紧,专有编排接口越深,替换成本越高、退路越窄。决策规则很清楚:凡打算长期多模型并存、或对供应商锁定与地缘风险敏感的组织,应当把编排层抽象在自己手里,只把 OpenAI 当作可替换的执行后端之一,而不让业务逻辑长在它的接口上。可观察的信号是:若 Responses API 的能力越来越多地以只能在 OpenAI 平台内使用的形式发布,锁定就在加深;若它转向更可移植的开放规范,这层顾虑会随之减轻。
Anthropic 用 MCP 连接工具与代码执行
Anthropic 走的是另一条路。据其公开说明,Model Context Protocol(MCP)是一套开放协议,用统一方式把模型连接到外部工具和数据源,任何厂商都能实现它的服务端或客户端。相比把执行循环收进专有接口,这一层押注互操作:工具一次接入,可被不同模型和客户端复用。它的另一份工程说明提出"用代码执行来调用工具"——当可用工具达到几十上百个,与其把全部工具定义塞进上下文,不如让模型改写并运行代码,通过代码去调这些接口、只在需要时按需加载定义,从而压低上下文开销与多步协调成本。
开放协议的战略含义,正是东盟买家在中美之间保留退路的技术支点。接入 MCP 的工具不必为每家模型重写,编排层理论上可以在美系与非美系模型后端之间切换——前提是对方也实现了兼容 MCP 的接口。这把"选哪家模型"从一次性豪赌变成可替换的后端决策。需要如实标注的是:中国厂商(如阿里、字节、腾讯、华为)的 agent/工具平台是否兼容 MCP、其能力边界如何,当前没有可核实的一手来源,一律按未经核实处理,不作事实陈述,也不臆测其强弱。
代码执行则把一部分治理负担推给采用方。模型能写代码、能跑代码,执行环境里就多了一条真实攻击面——注入的指令可能变成实际运行的程序。用 MCP 加代码执行的组织,必须自己补齐沙箱隔离、权限最小化和执行留痕,协议本身不替你做这件事。一句需要校准的判断:开放不自动等于赢。MCP 的价值兑现,触发条件是足够多的工具方和模型方真按它接入、形成网络效应;反证信号是,若主要工具生态转而围绕某一家的专有接口聚集,开放协议就退回成小众选项。
Google 与 Microsoft 转向企业治理平台
Google 和 Microsoft 的切入点更靠近大企业的采购逻辑。据各自产品资料,Google Cloud 的 Gemini Enterprise Agent Platform 把构建、扩展、治理和优化 agent 摆成一套企业平台能力;Microsoft 的 Copilot Studio 把 agents、工作流,以及能操作计算机界面的 computer-using agents 纳入企业产品线。两者的杠杆是既有企业存量:用 Microsoft 365 或 Google Workspace/Cloud 的组织,身份、权限、合规和数据边界已在平台里,agent 直接落进这套治理框架,采购与安全审查的阻力比引入一个独立新供应商小得多。这两家的竞争筹码是把 agent 接进企业已有的管理体系,而非单点模型能力。
对新加坡和东盟企业,这条线牵出一个具体的中美—区域三角决策,而不只是地缘背景。三角的三条边各自落到可核实的机制上:美系平台栈把治理和身份控制做进产品,采购顺滑,但执行与控制平面仍在美国供应商手里,受其出口管制与政策约束;中国厂商 agent 平台是否满足东盟本地数据驻留、能力如何,目前缺一手来源、无法判定;而开放协议 MCP 是让编排层不被任一侧锁死、从而保留切换空间的技术前提。据此给东盟 CTO 一条选择点决策规则:先按监管暴露分档——若合规要求你必须保留一个非美后端、且对跨境数据出境敏感,就把编排层锚在开放协议上,把任何单一模型后端(无论美系或中国厂商)都当作可替换件;只有在上线速度的收益明显压过战略集中风险、且你负担得起日后重做编排时,才接受专有编排接口。谁的平台能让 agent 天然继承企业已有的身份与合规控制,谁就在这类采购里占先,这也是 Google 和 Microsoft 把"治理"放在营销第一行的原因。
需要校准的是:平台治理能力目前多来自厂商自述产品页,真实的管控颗粒度、审计深度和跨系统权限一致性,仍需实际部署验证——这一点按未经独立核实处理。可观察的反证信号是,若大型受监管行业在试点后仍普遍自建治理层、绕开平台自带能力,这些"企业级治理"的成色就被高估了。
| 平台 / 路线 | 可核实的执行层卖点 | 锁定深度(估计) | 可移植性 / 开放程度 | 东盟采购要点 |
|---|---|---|---|---|
| OpenAI(Responses API + Agents SDK) | 把模型请求—触发工具—回填—续步的运行循环合进单一专有接口,托管执行控制流 | 高:核心编排逻辑绑定单一美国供应商,迁移需重写整套编排与工具接入 | 低:专有接口,能力多以平台内形式发布 | 叠加中美变量——出口管制、账号或价格收紧时,接口越深退路越窄;宜把编排层抽象在自己手里 |
| Anthropic(MCP + 代码执行) | 开放协议统一连接工具与数据源,工具一次接入可跨模型复用;代码执行按需加载工具定义压低上下文成本 | 中:编排层理论上可在后端间切换,但价值兑现依赖足够多工具方/模型方真按 MCP 接入 | 高:开放协议,任何厂商可实现服务端/客户端 | 在中美间保留退路的技术支点;代码执行把沙箱隔离、权限最小化、执行留痕的治理负担推给采用方 |
| Google / Microsoft(Gemini Enterprise / Copilot Studio) | 把构建、治理、工作流与 computer-using agent 接进企业已有身份、权限与合规边界,采购与安全审查阻力低 | 高:随存量办公与云环境沉淀为工作流与开发者习惯,替换的是执行流程而非模型 | 中低:治理能力多来自厂商自述产品页,管控颗粒度待实际部署验证 | 执行与控制平面仍在美国供应商手里,受其政策约束;反证信号是受监管行业试点后仍普遍自建治理层 |
| 中国厂商 agent / 工具平台 | 是否兼容 MCP、能力边界与本地数据驻留满足度当前无可核实一手来源 | 未经核实 | 未经核实 | 按未经核实处理,不作事实陈述也不臆测强弱;若要竞争需证明能提供同等完整的企业执行层,而非只给更便宜的模型调用 |
把选型坐标从模型跑分换成执行层:先看可核实的执行卖点与锁定深度,再决定是否把编排锚在开放协议上、让任一模型后端都可替换。
平台把执行环境打包成默认能力
当 agent 只会生成文本,平台卖的是模型接口;当它能调用工具、运行代码、操作浏览器和计算机界面,平台卖的就变成一整套执行环境。OpenAI 把 Responses API、Agents SDK 和工具能力放在同一条开发路径上;Anthropic 用 MCP 把模型与外部系统连接起来;Google 和 Microsoft 则把 agent 构建、工作流和企业管理收进云平台。几家公司看似在比功能,实质是在争夺企业自动化的默认运行层。
这会改变采购结构。过去企业可以把模型、向量库、工作流和权限系统拆开选型;执行环境被平台打包之后,采购会被推向“整套平台能力”而不是“单点模型能力”。一旦代码执行、浏览器操作、工具连接、任务编排和管理界面都来自同一云平台,替换模型本身反而不是最难的部分,难的是替换围绕模型建立的执行流程和开发者习惯。
对东盟买家,这个变化比单纯的模型跑分更现实。美国平台把执行环境做成默认云能力,意味着采购不再只是选择一个 API,而是在选择一套自动化基础设施:它会影响开发团队的工具链、数据驻留安排、合作伙伴生态和未来议价能力。中国厂商若要竞争,也不能只给更便宜的模型调用,而要证明自己能提供同等完整的企业执行层。
默认执行层的锁定,不发生在模型本身
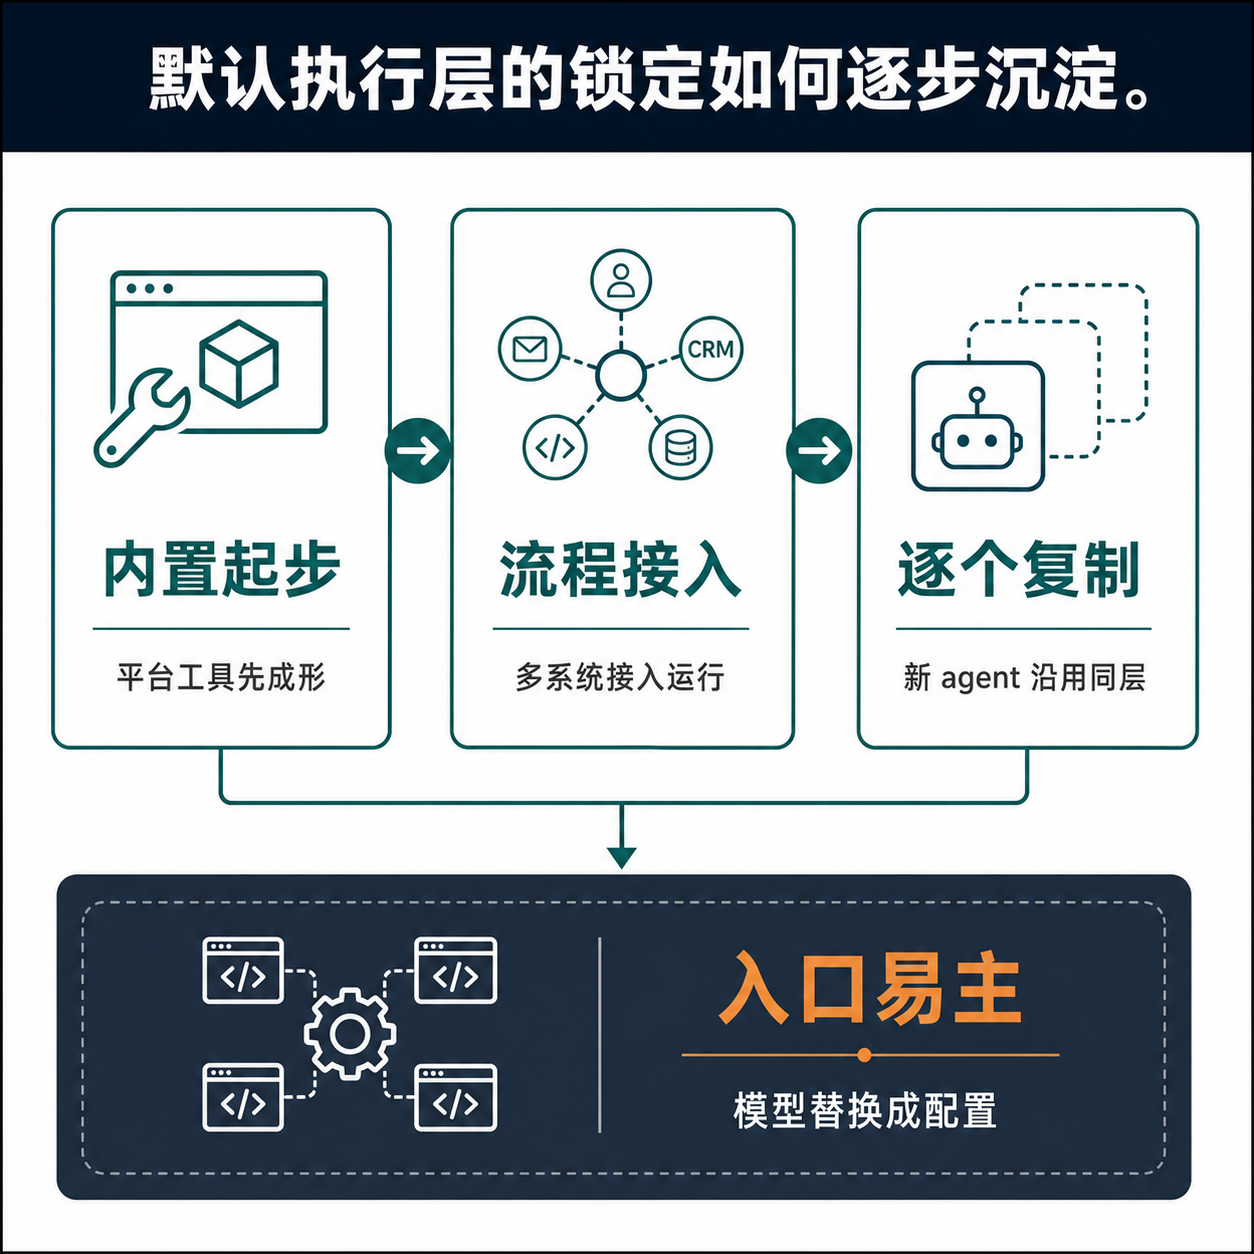
最后的判断,是选型坐标正在从模型后端转向默认执行层。模型后端可以更换,真正黏住企业的是围绕 agent 执行环境形成的工作流、插件、开发者接口、权限系统和运营习惯。美国平台公司的优势不只在模型能力,而在它们能把这些部件预装进云与办公软件,让企业在“顺手采用”的过程中把下一代自动化入口交给同一套平台。
这种锁定路径不同于传统 SaaS 的合同锁定,也不同于单纯 API 价格带来的迁移成本。它更像操作系统层面的习惯沉淀:开发者先用平台内置工具写第一个 agent,业务部门再把审批流、CRM、邮件、代码仓库和数据接口接进去,随后每一个新 agent 都沿着同一套运行层复制。半年后,企业发现自己依赖的并不是某一个模型,而是已经分布在十几个业务流程里的执行环境。
这也是美国平台把 agent 执行能力做进云产品的真正战略价值。它不需要立即证明某个模型永远领先,只要让企业的自动化项目默认从它的执行层开始,模型替换就会被降格为后端配置,平台位置却不断加深。东盟买家读这件事时,不应只问“哪个 agent 更能干”,而要问“我们的第一个 agent 会把后续一百个 agent 带向哪一层默认运行环境”。本文区别于治理审查文章的地方正在这里:风险不只在出错后谁负责,更在企业还没意识到锁定时,执行层已经变成了自动化的入口。
资料来源
7 个公开来源,按文章核验用途列出。