开放效率对闭源平台:中美模型路线的企业取舍
开放权重和闭源平台的差别,不只是价格、跑分或意识形态,而是上线后责任放在谁身上。企业应按负载敏感度、运维能力和迁移成本拆分路线。
企业选择的是模型路线背后的责任结构
开放权重和闭源平台的分歧,经常被写成价值观之争:一边强调自由、低成本和开发者生态,另一边强调安全、托管和企业服务。对真正要上线 AI 的企业来说,这个框架太粗。采购部门真正要确认的是模型运行后的责任归属:谁修漏洞,谁管工具调用,谁保留日志,谁解释合规边界,谁在模型失控时能暂停服务。
美国平台路线正在把模型、工具和托管执行环境打包。OpenAI 的 Responses API、web search、file search、computer use 和 Agents SDK,指向一套可被企业接入、监控和迭代的执行层。中国开放路线的优势在另一端。USCC 的 Two Loops 报告把中国开放 AI 策略写成两个循环:开放模型扩散带来开发者反馈,工业部署再产生应用数据和场景反馈。Alibaba Cloud 的 Qwen 方案则把开放模型、PAI-EAS 部署、微调和 Model Studio 放进云产品里,让企业更容易把模型搬进自己的行业流程。Alibaba Cloud 还披露,Qwen 模型首年吸引超过 9 万家企业采用;这个数字不能直接证明生产效果,但足以说明开放模型的扩散速度已经进入企业采购视野。
中国开放效率:扩散快,适配快,责任也更靠近部署方
中国开放权重路线的真实优势,是把试错成本压低。Qwen 这类模型能被下载、微调、私有化部署,也能通过云平台快速接入。USCC 报告提到,Qwen 在 Hugging Face 上形成大量衍生模型;开放权重在这里是一种生态扩散机制。开发者越多,适配越快,行业模板越容易出现;行业部署越多,又会把真实工作流、文档、语言和边缘案例反馈给模型生态。Brookings 对中美 AI 策略的判断也提供了独立视角:这场竞争横跨算力、模型、采用、集成和部署,不能只看单一模型榜单。
但开放效率不是免费午餐。企业一旦把模型放进自己的云、自己的数据湖和自己的业务系统,很多责任会转移到部署方。安全补丁、版本漂移、提示注入防护、日志留存、越权工具调用、个人数据处理,都不能简单推给模型发布者。采购团队如果只看推理成本和模型排名,会低估运维和合规成本。一个银行客户用开放模型做内部知识检索,可能省下平台调用费,却要自己证明数据没有流出、向量库权限没有越权、模型升级没有改变答案边界。衍生模型越多,供应链问题也越明显:谁维护微调后的权重,谁确认基础模型更新不会破坏安全策略,谁在社区版本出现漏洞时通知下游企业,这些都需要在合同和运维流程里写清楚。
美国闭源平台:集成度高,但锁定也更深
美国闭源平台的强项,是把复杂度收到供应商合同里。OpenAI 的 agent 工具方向显示,平台正在把模型、工具、检索、文件、浏览器式执行和 SDK 整合成可管理的开发表面。企业买到的不只是回答能力,还包括工具调用、上下文管理、运行监控、模型升级和安全策略的默认组合。对没有强 AI 平台团队的企业,这种托管能力很有吸引力。
代价是锁定。闭源平台的安全边界、计费结构、模型升级节奏、数据处理条款和工具执行规则,都由供应商决定。一个区域零售集团如果把客服、搜索、商品推荐和内部报表都接到同一闭源 agent 平台,短期部署会很快;但三个月后要迁移到另一个模型,可能发现提示、工具 schema、审计日志和评估集都绑在原平台上。平台越完整,退出成本越高。
新加坡和 ASEAN 的实际取舍:哪类负载放哪条路线
对新加坡和 ASEAN 企业,更实用的做法是按负载拆分。第一类是高敏感、强合规、需要本地控制的数据工作,例如金融风控、政府文档、医疗记录和内部知识库。这类负载适合优先评估开放权重或可私有化部署路线,因为数据边界、日志和审批可以落在企业自己的环境里。第二类是需要快速上线、工具链完整、业务风险可控的任务,例如营销素材、客服草稿、销售线索整理和公开信息检索。这类任务适合闭源平台,因为平台集成度和模型更新速度更重要。
第三类最难:会行动的 agent。它既需要工具调用、执行环境和监控,也涉及权限、数据和审计。这里的决策核心是责任链:谁批准工具权限,谁保存动作日志,谁处理模型升级后的回归测试,谁在事故后向客户和监管解释。开放路线给企业更多控制权,也要求企业有工程和治理能力;闭源路线给企业更快的产品面,也要求企业接受供应商定义的边界。
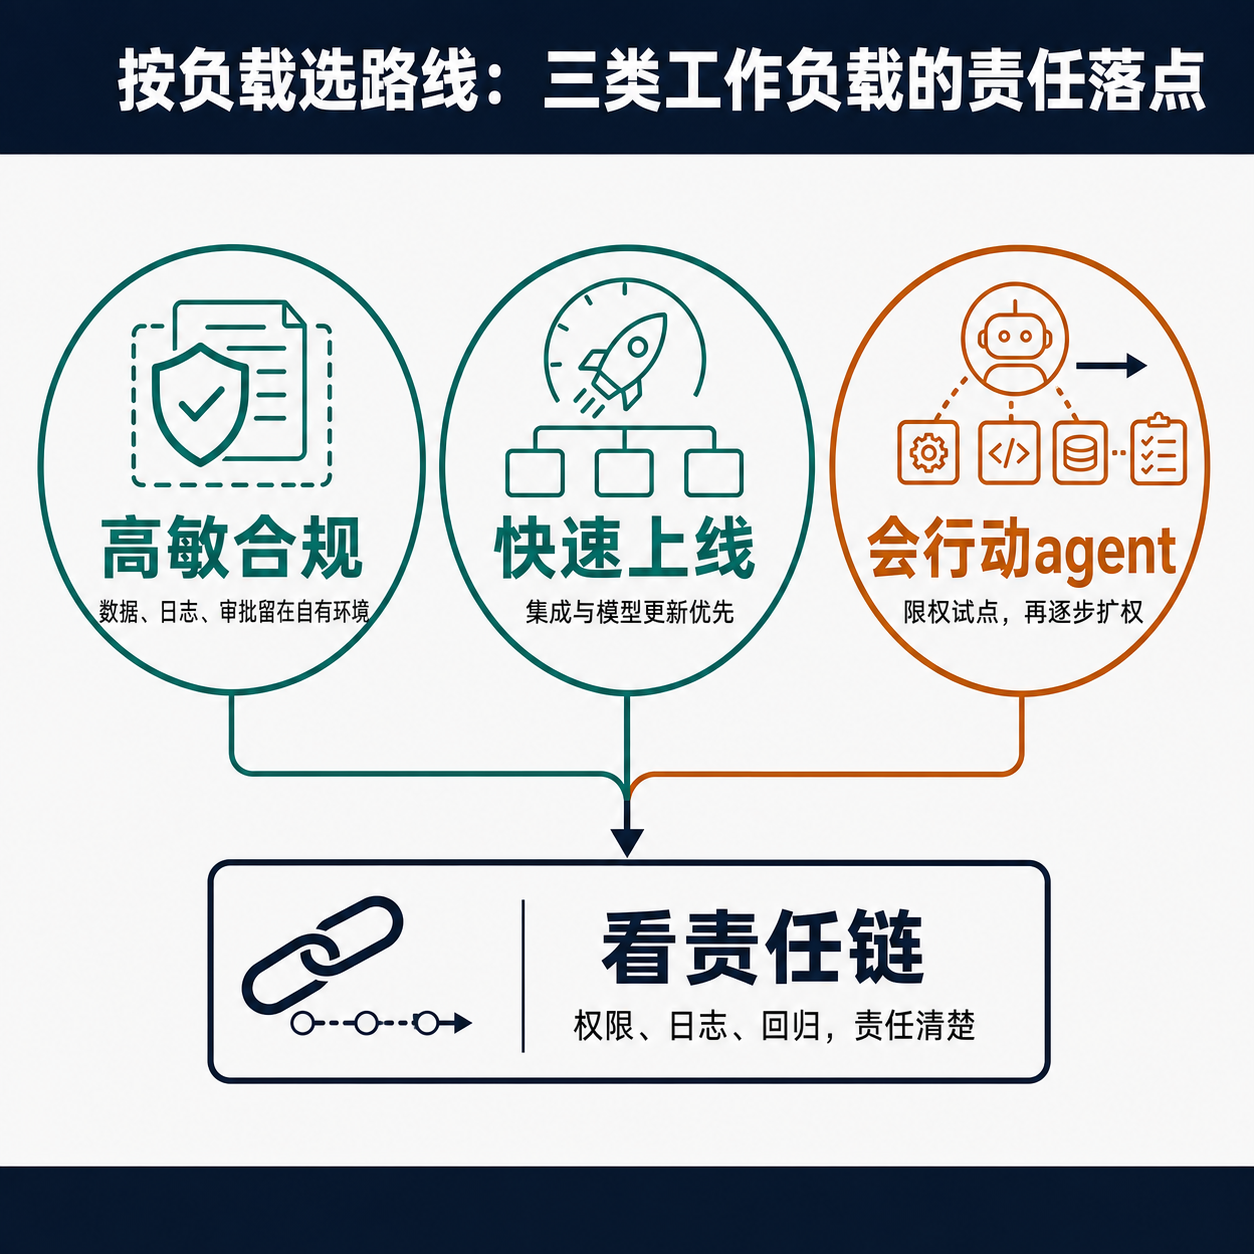
决策清单:四个问题比模型榜单更重要
第一,数据能否离开当前司法辖区。如果答案是否定,开放权重或私有化部署的权重更高。第二,业务是否需要供应商承担运行责任。如果团队缺少模型运维、安全评测和日志审计能力,闭源平台的托管优势更明显。第三,未来是否需要迁移。若迁移概率高,企业应避免把工具 schema、评估集和业务流程深度绑定到单一平台。第四,成本是短期调用费还是长期总拥有成本。开放模型省下的 API 费用,可能会被工程、监控、合规和升级成本吃掉。
这四个问题能把“开放效率”和“闭源平台”从口号变成采购规则。中国开放生态的优势,是速度、成本和本地适配;美国闭源平台的优势,是集成、托管和责任打包。更成熟的企业会在两个条件同时出现时采用分层路线:一是业务负载的敏感度差异足够大,二是内部团队有能力管理至少两套模型治理流程。敏感数据和核心知识走可控路线,低敏流程和快速试验走托管路线,会行动的 agent 先小范围限权上线。一个反证信号也要写清楚:如果某个闭源平台开放可迁移的工具 schema、可导出的评估集和可审计日志,锁定成本会下降,企业就不必为了“可迁移”而承担全部开放部署责任。
| 负载类型 | 推荐路线 | 责任落点与关键控制 | 主要风险/需在合同里写清 |
|---|---|---|---|
| 高敏感、强合规、需本地控制(金融风控、政府文档、医疗记录、内部知识库) | 优先开放权重/可私有化部署 | 数据边界、日志留存、访问审批落在企业自有环境;安全补丁与版本管理由部署方负责 | 运维、监控、合规、升级成本转移到部署方;衍生权重维护与漏洞通知责任需在合同中明确 |
| 需快速上线、工具链完整、业务风险可控(营销素材、客服草稿、销售线索整理、公开信息检索) | 闭源托管平台 | 供应商承担运行责任、模型更新、工具执行规则与默认安全策略 | 退出成本高;计费、数据处理条款与升级节奏由供应商定义,迁移时提示、schema、审计日志和评估集可能被锁定 |
| 会行动的 agent(工具调用+执行环境+权限与审计) | 按责任链决策,先小范围限权上线,不按模型名选型 | 明确谁批准工具权限、谁保存动作日志、谁做升级后回归测试、谁向客户与监管解释事故 | 越权工具调用、模型升级回归、事故追责不清;开放路线要求工程与治理能力,闭源路线要求接受供应商边界 |
路线应按负载敏感度和责任落点决定,而不是按模型榜单,会行动的 agent 一律先小范围限权上线。
声明台账:哪些判断可以承重
| 声明 | 状态 | 主要来源 | |---|---|---| | 中国开放 AI 策略通过模型扩散和工业部署形成反馈循环 | 已核权威分析 | USCC Two Loops | | Qwen 可通过 Alibaba Cloud 进行部署、微调和企业方案接入 | 已核厂商一手来源 | Alibaba Cloud Qwen | | Alibaba Cloud 称 Qwen 首年吸引超过 9 万家企业采用 | 已核厂商一手来源,不能直接证明生产效果 | Alibaba Cloud | | OpenAI 正在把模型、工具和 agent 开发能力整合成平台服务 | 已核厂商一手来源 | OpenAI Responses API / agent tools | | 企业路线选择应按负载敏感度、运维能力、迁移成本和责任链拆分 | 分析判断 | 由以上来源交叉推出 |
这张台账的作用是划出证据边界。它足以说明开放生态和闭源平台正在形成两套不同的企业交付路径,也足以支持按负载敏感度、运维能力和迁移成本拆分路线;它还不能支持一个更强判断:哪条路线在所有行业里总拥有成本更低。公开来源缺少可比的长期 TCO、事故率、迁移成本和维护人力基准,厂商披露也通常只证明采用规模或产品能力,不能直接证明生产效果。
因此,企业下一步最稳妥的动作,是把每个 AI 负载的责任结构写成采购附件。附件里要列清数据边界、补丁责任、日志留存、权限审批、评估集归属、迁移出口和事故解释人。开放路线适合愿意自持这些责任的团队;闭源平台适合愿意把部分责任写进服务关系的团队。本文能给出的最终边界是:路线选择的真正分界线,落在上线后责任由谁承担、由谁证明、由谁持续维护。
资料来源
6 个公开来源,按文章核验用途列出。
- 政府资料Two Loops: How China’s Open AI Strategy Reinforces Its Industrial Dominance
- 原始资料New tools for building agents
- 原始资料Alibaba Cloud Qwen generative AI solution
- 权威机构Competing AI strategies for the US and China
- 原始资料Alibaba Cloud's Qwen Models Attract over 90,000 Enterprise Adoptions within Its First Year
- 原始资料New tools and features in the Responses API