开放权重是中国 AI 的产业战术,不只是开源精神
2024 年末,DeepSeek 通过公开的 GitHub 仓库与模型仓库发布 DeepSeek-V3:一款总参数约 6710 亿、每个 token 仅激活约 370 亿参数的混合专家(MoE)模型,权重直接挂网可下。这更接近一次分发动作,而非一次实验室跑分的展示——开发者不必申请额度、不必等商务审批,就能把整套权重拉到本地运行、按自己的数据微调、嵌进自己的产品。 中国模型用低门槛换生态密度
开放权重首先是一次进入市场的动作
2024 年末,DeepSeek 通过公开的 GitHub 仓库与模型仓库发布 DeepSeek-V3:一款总参数约 6710 亿、每个 token 仅激活约 370 亿参数的混合专家(MoE)模型,权重直接挂网可下。这更接近一次分发动作,而非一次实验室跑分的展示——开发者不必申请额度、不必等商务审批,就能把整套权重拉到本地运行、按自己的数据微调、嵌进自己的产品。
把这类发布读成"开源精神",会低估它的战术含义。开放权重的第一重身份是一套分发机制:它把"一种能力"变成一个可复制、可改写、可在本地承载的对象,绕开托管式 API 的两道闸门——调用配额与商业授权。闭源模型的能力锁在供应商服务器后面,扩散速度由供应商的商务节奏决定;权重一旦公开,这条链路的控制权就移交给下游。
由此得到一条可以随身带走的读法:看到一次高调的开放权重发布,先把它当成一次进入市场的动作,追问谁在下游把它装进了产品、它把"从下载到进生产"这段路缩短了多少——而不是它在某张榜单上排第几。评估这些模型的坐标系,是装机量与集成深度。
中国模型用低门槛换生态密度
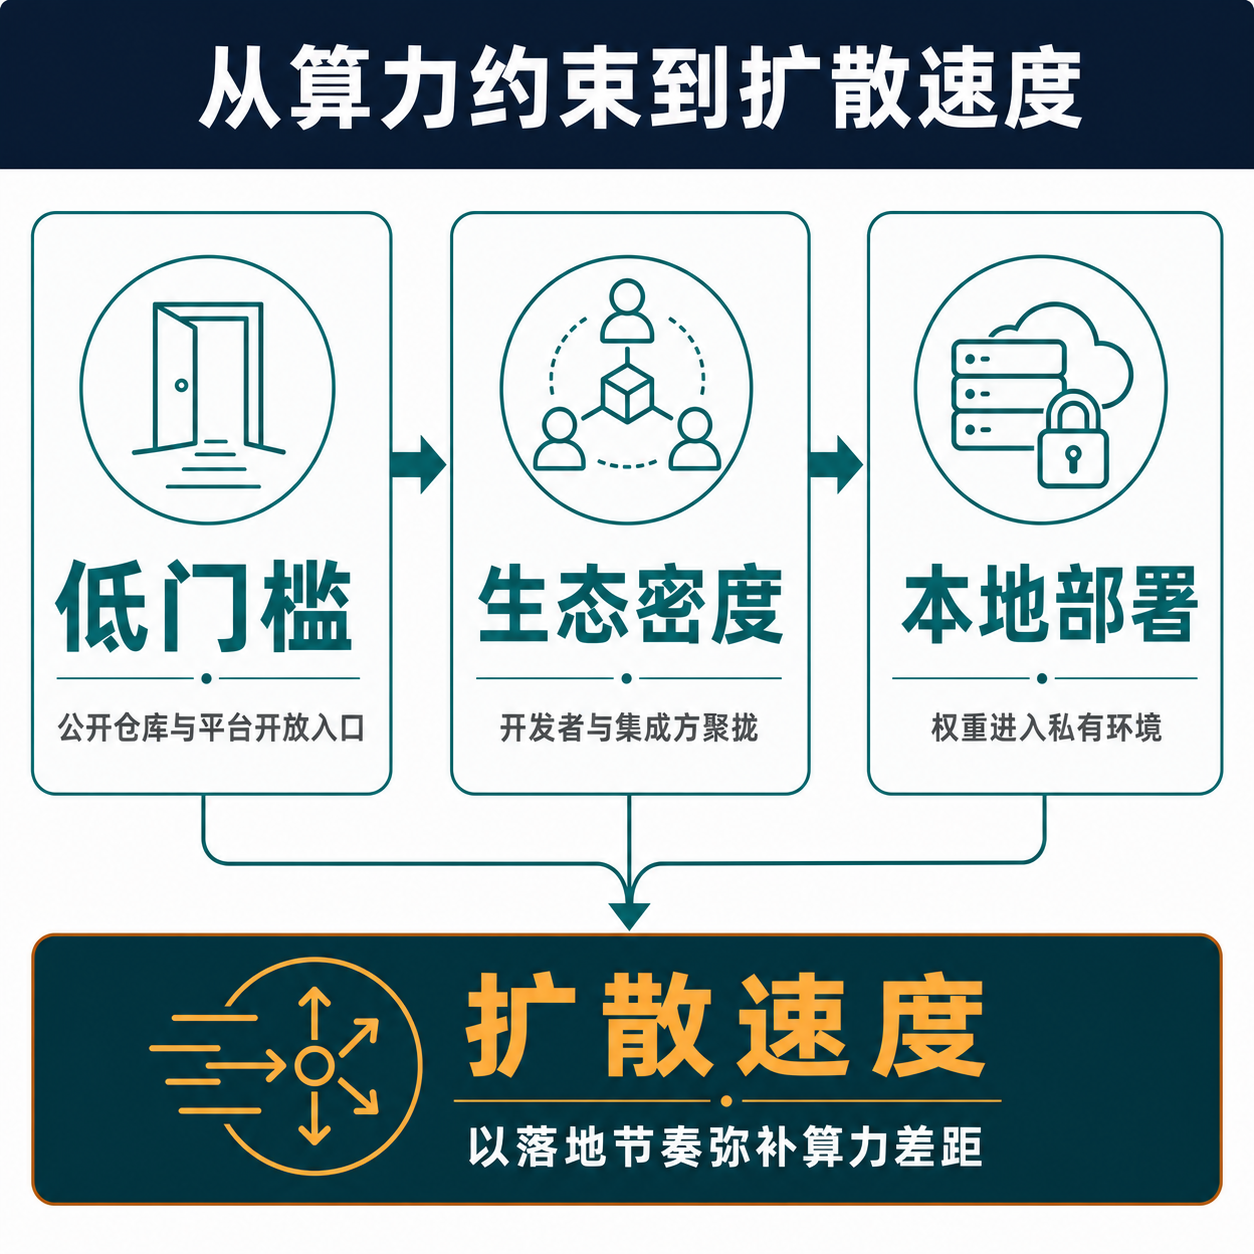
USCC 在《Two Loops》里用"双循环"机制描述中国的开放 AI 策略,并把它与产业主导地位直接挂钩。顺着这个框架,开放权重是一笔明确的交换:放弃按调用收费、按授权分层的那部分直接收入,换取更宽的采用面。门槛越低,愿意在同一基座上搭建的开发者越多;开发者越多,围绕这个基座的工具、微调版本、部署经验就越密集;这层密度反过来让基座更容易成为下游的默认选择。
这套逻辑的力量在于复用摩擦有多低,而非单个模型的峰值分数。以 DeepSeek-V3 的结构为例:6710 亿总参数里每次只激活约 370 亿,意味着同等能力上限下的单次推理成本被显著压低——参数规模决定能力天花板,激活规模决定每次调用的算力账单,这正是把"重新集成到底划不划算"往下游一侧压的杠杆。Qwen 则在 Hugging Face 上以一整个组织仓库的形式分发从小到大的多个尺寸,让一家企业能按自己机房的算力选型、把权重放进自己的边界、不必把敏感语料送出去。(公开可查的具体下载量与命名企业部署规模尚待核实,此处不以未证实的采用数字支撑判断。)
一条决策规则随之成立:评估一款开放权重模型的产业价值,先算它把"从下载到进生产"缩短了多少,再看基准分数。触发条件是下游价值主要在集成环节沉淀;一个反向信号值得盯住——若头部闭源模型的能力代差大到让重新集成也划算,密度优势就会被重新定价。
美国政策圈如何解读产业回路
Brookings 把中美 AI 竞争刻画为策略路线的差异,而不是一张模型排行榜上的名次之争;RAND 关于 AI 市场竞争的研究,把采用、市场与生态因素放在与前沿能力同等重要的位置。两处判断的共同点,是把分析单位从"单个模型"换成"回路":一个基座被下游装上后产生的工具、数据与部署经验,会回流强化这个基座本身。
更值得注意的是提出这套解读的位置。USCC 是美国国会下设的安全审查机构,它把中国开放策略写成"强化产业主导地位"的双循环,说明这条路线已被当成战略变量、而不是技术慈善来对待。政策圈的关切不在于某个开源模型是否"厉害",而在于扩散本身会不会沉淀成难以撼动的产业位置。对创始人与投资人,这里的信号是:官方叙事正从能力竞赛转向生态卡位;出口管制、采购审查与合规动作的下一步,更可能沿着"谁的基座在别人产业里跑"这条线展开,而非沿着榜单名次。
三家机构对"产业回路究竟谁占优"的量化口径并不一致,尚不足以据此给出统一的市场份额结论;可确认的,只是它们共同指向的这一框架转向。
开放不等于没有治理成本
开放权重把控制权交给下游的同时,也把一部分治理责任一并交出,这是结构性代价。权重一经公开就无法召回:任何人都能保留副本、绕过原厂的更新与下线。围绕安全对齐所做的约束,在自由微调面前也会松动——下游有能力按自己的目标重新训练模型的行为边界。对以能力扩散为战术的一方,这既是采用红利,也是外溢风险。
对新加坡与 ASEAN 的企业选型者,这层成本要落到清单上再决定:
- 数据是否真正留在本地边界内; - 模型来源与训练脉络是否可追溯; - 行业合规与内容责任由谁承担; - 一旦基座被曝出问题,退出与替换的路径是否存在。
把这些写进采购前的评估表,比事后补救便宜得多。需要标注为待核实的是:不同司法辖区对开放权重模型的具体合规要求仍在演变,这里不逐条断言监管细则,只主张把治理成本前置为选型的一等约束,而非上线后再处理的附带事项。
本图为编辑分析框架的相对权重示意,非实测或自报数据;用于说明竞争重心正从单一模型排行,转向采用、生态与部署等维度(依据 Brookings 与 RAND 的策略性判断)。
竞争焦点从参数转向部署
如果价值主要在部署环节沉淀,中国路线的优势更可能显现在场景覆盖、价格结构、开发者规模与行业适配上,而不在某项基准的绝对领先。这与 RAND 强调采用与市场、Brookings 强调策略差异是一致的:一条把算力约束转化为应用扩散速度的路径,赌的是下游的广度。
这个判断需要校准,不能当成必然。它成立的触发条件,是能力代差保持在"足够好即可用"的区间内——当多数生产场景对模型能力的需求趋于饱和,部署效率就压过前沿分数。一个反向信号值得长期盯住:若头部模型在推理、长上下文或可靠性上再度拉开代际差距,让前沿能力重新成为稀缺资源,竞争焦点会被拉回参数与训练,部署优势随之贬值。
因此真正该持续监测的,是"能力饱和线"与"前沿代差"这两条曲线的相对位置:前者上移、后者收窄,装机深度就结算这场竞争;后者重新张开,前沿参数把结算权收回。DeepSeek-V3 用 MoE 把单次调用成本压到激活约 370 亿参数的量级、Qwen 用多尺寸覆盖不同算力预算,都是在饱和线一侧下注的具体动作——它们的胜负,要到这两条曲线交叉的地方才揭晓,而不在下一次榜单更迭。
| 决策维度 | 支持采用开放权重的条件 | 需要警惕的反证信号 | 来源依据 |
|---|---|---|---|
| 应用扩散速度 | 本地试验与二次开发门槛低,能把算力约束转化为落地速度 | 内部缺乏工程团队消化权重,扩散停留在下载而非上线 | USCC 双循环机制;Qwen/DeepSeek 公开模型仓库(PRIMARY) |
| 本地部署与数据合规 | 监管或客户要求数据不出境,权重可控部署满足合规 | 所在司法辖区对中国模型来源有采购或安全限制 | USCC 产业回路论述;DeepSeek-V3 GitHub(PRIMARY) |
| 开发者生态密度 | 已有社区、工具链和微调经验,降低集成与维护成本 | 目标场景缺少可复用生态,需从零自建支持 | Brookings 策略差异论述;RAND 采用与生态因素(AUTHORITATIVE) |
| 治理与安全成本 | 具备能力扩散、安全与合规的内部管控能力 | 无独立评测与安全护栏能力,治理成本被低估 | USCC 治理成本提示(AUTHORITATIVE,本行为 AI Bridge 编辑估计) |
| 竞争焦点:部署而非参数 | 优势来自场景、价格与行业适配而非榜单排名 | 选型仍以单一参数或排行榜为准,忽视部署适配 | Brookings/RAND 多维竞争论述(AUTHORITATIVE) |
把中国开放权重当作产业战术而非开源理念来评估:只有当本地部署、生态密度和场景适配的收益能覆盖治理与合规成本时才纳入选型,一旦出现反证信号就应重新评估。
资料来源
5 个公开来源,按文章核验用途列出。