前沿模型安全护栏正在变成可核对的行为接口
前沿模型的竞争正在把一件过去藏在内部政策里的事推到台前:模型愿意听谁的话、在什么边界上停下来,如今被写成可以逐条阅读的公开文档。OpenAI 公开的 Model Spec 就是这样一份文件,它把“模型应当如何回应、在指令冲突时如何取舍”从工程师的隐性判断,变成对外可查的行为规范。 美国厂商把安全写进模型规范
护栏先变成行为接口
前沿模型的竞争正在把一件过去藏在内部政策里的事推到台前:模型愿意听谁的话、在什么边界上停下来,如今被写成可以逐条阅读的公开文档。OpenAI 公开的 Model Spec 就是这样一份文件,它把“模型应当如何回应、在指令冲突时如何取舍”从工程师的隐性判断,变成对外可查的行为规范。配套的 instruction hierarchy 更进一步,把系统指令、开发者指令与终端用户输入排成明确的优先级,并公开测试模型在遭遇越权指令时能否守住这条线。
这篇稿子的独立判断不在“治理会影响采购”这个宽泛结论,而在更具体的一层:安全护栏正在变成模型的行为接口。企业接入一个模型时,读到的不只是使用条款,而是一份可以像 API 契约那样逐条核对的行为说明——它在什么情况下拒答,如何处理相互矛盾的指令,把谁的权限置于最高。接口的价值在于可调用、可复测、可追责;行为边界如果写不清,就无法被纳入企业系统的权限设计。
对采购方,可带走的动作是把“安全”拆成接口测试,而不是听供应商口头承诺。评审不应只问模型是否安全,而要逐条问:拒答规则能否被复现,开发者指令能否压住用户越权,日志能否解释一次边界决策。头部厂商愿意公开行为准则,原因也在这里:公开本身构成可信度信号,边界写得越具体、越可复测,在企业评审里越像产品能力,而不是合规话术。
美国厂商把安全写进模型规范
如果说 Model Spec 处理的是"模型对谁负责",Anthropic 的 Responsible Scaling Policy 处理的是"更强的能力该以什么节奏放出来"。这份政策把模型能力分级,并规定当模型跨过某一能力门槛时,必须先完成对应的安全评估、部署缓解措施与治理审批才能发布。安全评估被前置到能力发布的关键路径上,成为放行条件,而非事后补救。
NIST 的生成式 AI 框架(AI 600-1)从另一端给出同一信号。它把内容来源与真实性、信息完整性、滥用风险、数据隐私,以及上线后的持续监测,一并列为需要治理的对象。这份文件面向的是部署方,意味着"发布之后还要盯多久、盯什么"也被写进了标准。
对投资人和 CTO,这里的判断是:美国头部厂商正在把安全从产品外围的合规检查,搬进能力迭代的内循环。触发条件是模型能力持续逼近高风险门槛;一个可以反向验证的信号是——如果某家厂商在发布更强模型时拿不出配套的评估与缓解说明,它其实还停在旧节奏里。RSP 是否真正约束了发布决策,要看它在下一次重大能力跃迁时是否真的推迟过上线,而不只是写在纸面上。这条区分很重要:一份从未挡下任何一次发布的安全政策,与营销话术没有实质差别。
中国监管把生成服务放进责任框架
中国走的是另一条路径:先立责任,再谈能力。《生成式人工智能服务管理暂行办法》由国家互联网信息办公室等部门出台,直接把"提供生成式 AI 服务"界定为一种需要担责的行为。训练数据的来源合法性、生成内容的安全性、个人信息保护,都被明确压到服务提供者身上。
这套逻辑的落点与美国厂商的自律文件不同。Model Spec 和 RSP 是企业写给市场看的承诺,可以随版本更新;暂行办法则是外部强制义务,合规与否关系到能否在境内合法提供服务。对一家想同时服务中美市场的公司,护栏是一道双重问责题:既要向企业客户证明模型行为可控,也要向监管者证明服务全链条可追责。
对创始人,可带走的判断是:进入中国市场的门槛更多落在合规链条上——数据来源、内容审核和个人信息处理能否做成可出示的记录,模型能力本身反而是次要关卡。判断一家公司是否真的准备好,看它有没有把这些义务落成流程与留痕,而非停在一句"我们符合规定"。两套体系正在把同一批工程能力,从不同方向催成硬性要求。
企业采购看的是可审计边界
企业客户评估一个模型时,会追问几个很具体的问题:面对提示注入(prompt injection),系统指令能不能守住优先级?敏感数据会不会顺着输出泄露?模型行为异常时,谁有权限干预、如何升级处置?这些问题背后,是一整套可审计的边界要求。
Model Spec 里的指令层级,恰好对应第一个问题:它把系统与开发者指令排在用户输入之上,并公开测试模型抵抗越权指令的稳健性,这正是提示注入防护的底层机制。NIST 框架把数据隐私和上线后监测列为治理对象,对应数据泄露与持续处置。面向东盟市场,新加坡 AI Verify 基金会的生成式 AI 治理框架同样把测试、内容来源与安全事件处理列为企业落地的评估维度,给这一地区的采购方提供了可对照的清单。
对 CTO,决策规则可以很硬:把上述四类问题——指令优先级、数据隔离、权限升级、事件响应——做成打分项,要求供应商拿出可复测的证据,不能只收一份说明文档。谁能把这些边界做成可审计、可留痕的工程能力,谁就更容易通过企业的安全评审。
不过要给这条判断划定证据边界。公开的政策与规范文件能证明厂商与监管方正在把安全做成可出示的产品和硬性义务,这一点有据可查;但买方是否已经据此调整采购权重,目前缺少独立的买方侧数据。把安全问卷放到采购决策的核心,现阶段是一线观察,尚不能当作已被验证的行业统计。更稳妥的判断是:这条采购决胜线正在形成、需要持续观察,后续要盯的确认信号,是企业招标文件里安全问卷的权重是否真的开始高于能力跑分。能力再强,若在这份问卷上答不出可验证的机制,采购流程也会在合规环节把它拦下。
| 采购审计维度 | 对应风险 | 供应商需出示的可复测证据(通过判据) | 公开来源依据 |
|---|---|---|---|
| 指令优先级 | 提示注入使用户输入越权覆盖系统与开发者指令 | 对同一组越权提示可重复复现:开发者指令稳定压住用户输入,拒答规则可再现 | OpenAI Model Spec 与 instruction hierarchy 公开测试 |
| 数据隔离 | 敏感数据顺着模型输出泄露 | 在数据泄露场景下给出可重复的隔离与拒答响应及对应日志 | NIST AI 600-1 数据隐私治理项 |
| 权限升级 | 模型行为异常时无人有权干预或无处升级 | 可出示的干预权限与升级路径记录,异常处置可追溯到责任人 | 《生成式人工智能服务管理暂行办法》责任主体要求 |
| 事件响应 | 上线后监测缺位,安全事件无账可对 | 常态化红队、行为日志与安全事件处理流程,均可留痕复盘 | NIST AI 600-1 上线后持续监测;新加坡 AI Verify 生成式 AI 治理框架 |
评审模型安全不应收一份说明文档,而应就指令优先级、数据隔离、权限升级、事件响应四项,要求供应商拿出可重复运行的响应与留痕;答不出可验证机制的模型,能力再强也只能进低权限场景。
下一项指标:边界决策能否被复测
护栏一旦成为行为接口,下一轮差异化就不会停留在“是否有安全政策”,而会下沉到边界决策能否被外部复测。企业真正需要的不是一句“无法协助”,而是一套能解释拒答依据、权限优先级、事件留痕和升级路径的机制。常态化红队、行为日志、细粒度权限、事件响应和可解释拒答,都只是同一个指标的不同侧面:模型在边界处做出的每一次决定,能否被后来的人复盘。
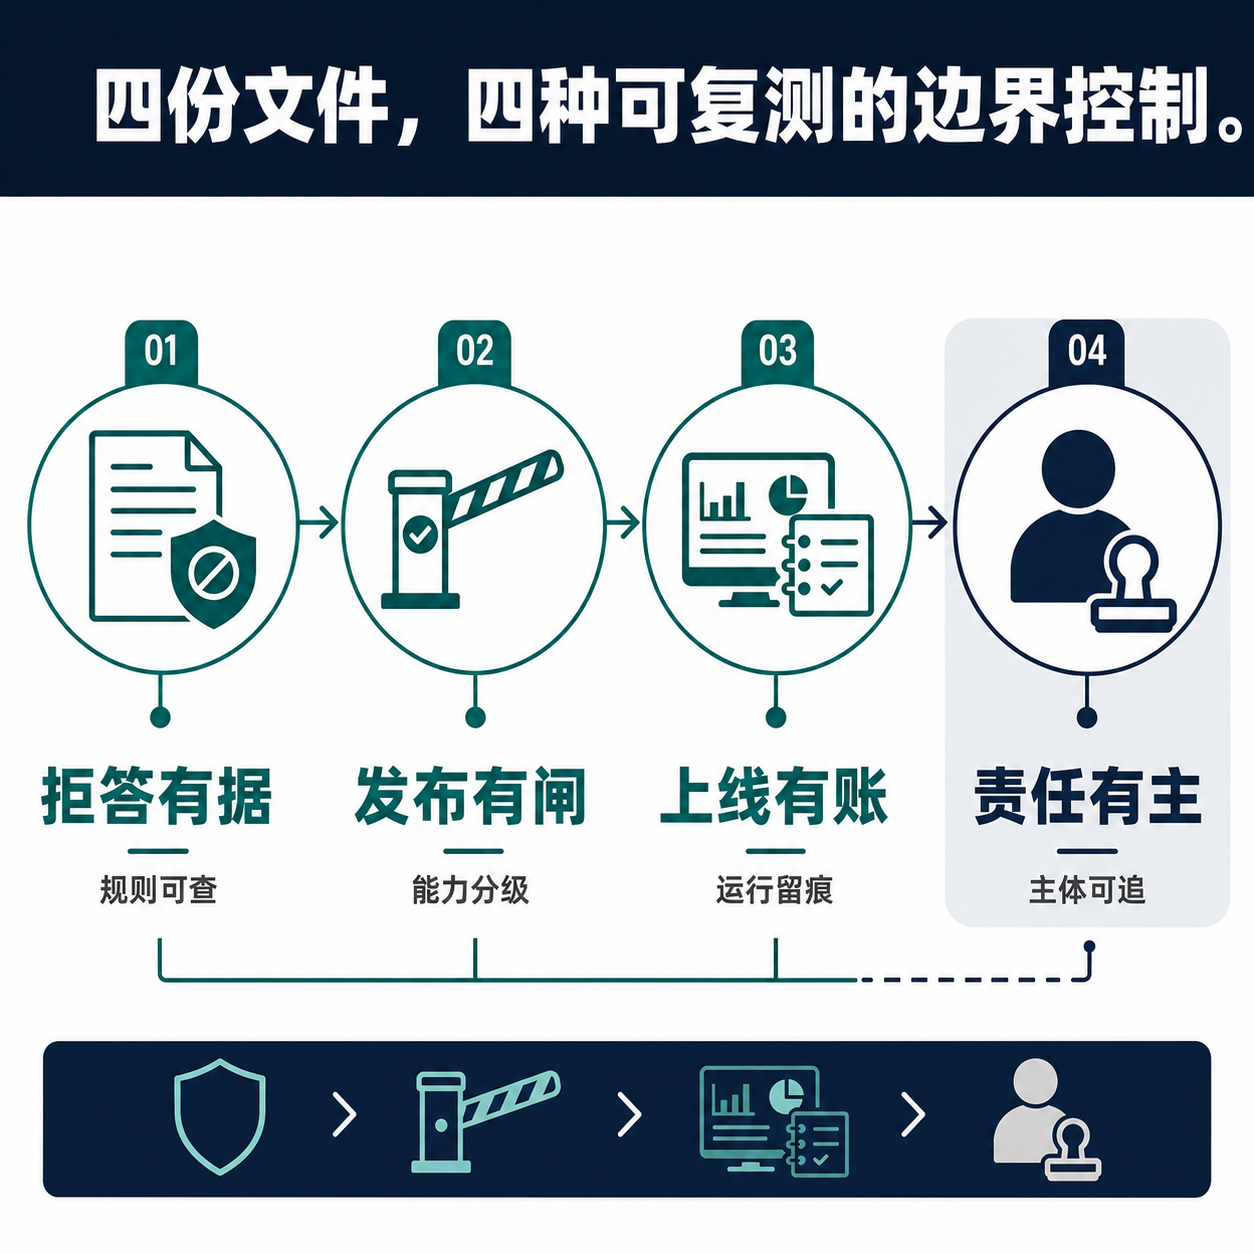
这与同栏目里关于治理文件进入采购规则的文章不同。那里讨论的是制度如何进入合同;这里讨论的是合同如何落到一次具体调用。Model Spec 让拒答有据可依,RSP 让能力发布有闸可查,NIST 框架让上线后有账可对,暂行办法让责任有主可追。四份文件最终都要落到一个工程问题:当一个请求被允许、拒绝或降级处理时,企业能否拿出一条可复测的解释链。
因此,护栏竞争的关键指标不是“安全团队说了什么”,而是“边界决策能否像接口一样被测试”。采购方可以把这件事写进验收:抽取一组高风险提示、权限冲突和数据泄露场景,要求供应商给出可重复的响应、日志和升级记录。能通过这组测试的模型,才真正把安全做成产品;通不过的模型,即使跑分领先,也只能被放在低权限、低风险的场景里使用。这个收尾属于本文:能力趋同时,胜负不在合规口号,而在边界接口的可测试性。
资料来源
6 个公开来源,按文章核验用途列出。